
llms.txt 是站点级的纯文本说明,Schema 是页面级的结构化标注。先统一事实、再铺 Schema、最后加 llms.txt,是不改版也能做的最低落地成本路径,附常见误区与教程索引。
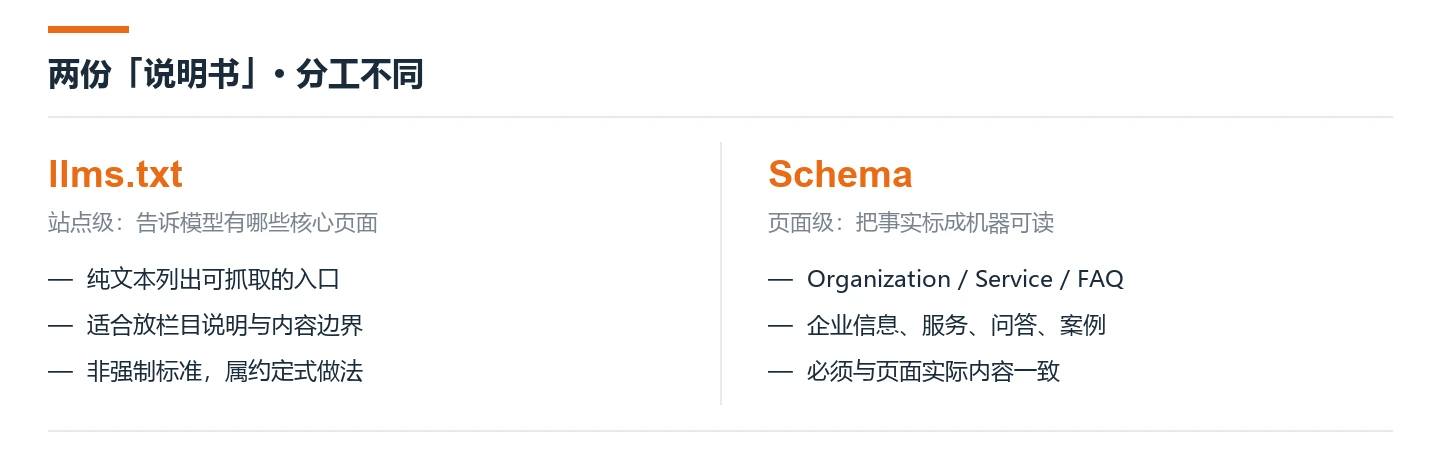
图|llms.txt 与 Schema:站点级与页面级,分工不同
在 GEO 的讨论里,llms.txt 和 Schema 经常被当成同一类东西,甚至被当成「打开 AI 收录的开关」。其实两者层级不同、作用不同,落地顺序也不同。把顺序理顺,往往不需要改版,就能把官网往「机器读得懂」的方向推进一大步。
一、各管什么
llms.txt 是站点级说明。通常是放在站点根目录的一份纯文本文件,用简洁的条目列出站点定位、核心页面入口与内容边界,相当于给大模型一份「站点说明书」。想了解定义可看《llms.txt 是什么?网站如何给大模型一份说明书》,需要模板可看《llms.txt 是什么、怎么写?给企业官网的一份实操模板》。
Schema 是页面级标注。它嵌在具体页面里,把公司信息、服务、问答、案例等标成机器可读的字段(如 Organization、Service、FAQPage)。概念见《Schema 结构化数据是什么?为什么 AI 搜索离不开它》,四类写法见《结构化数据怎么铺:企业信息、产品、FAQ、案例四类写法》。
一句话区分:llms.txt 告诉模型「这个站点有哪些值得看的页面」,Schema 告诉模型「这个页面里的这段文字是什么」。
二、最低成本的三步顺序
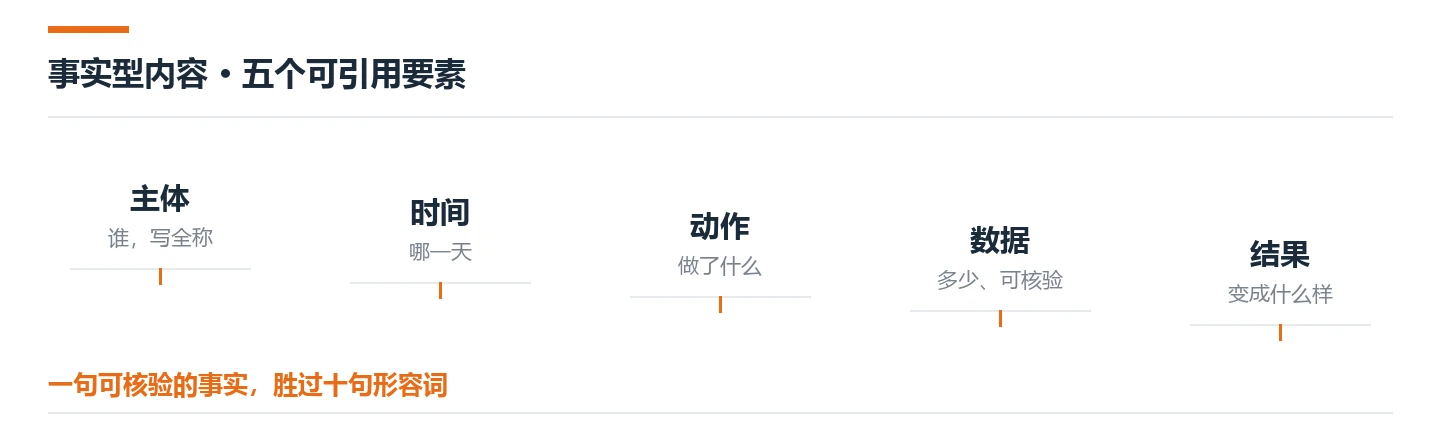
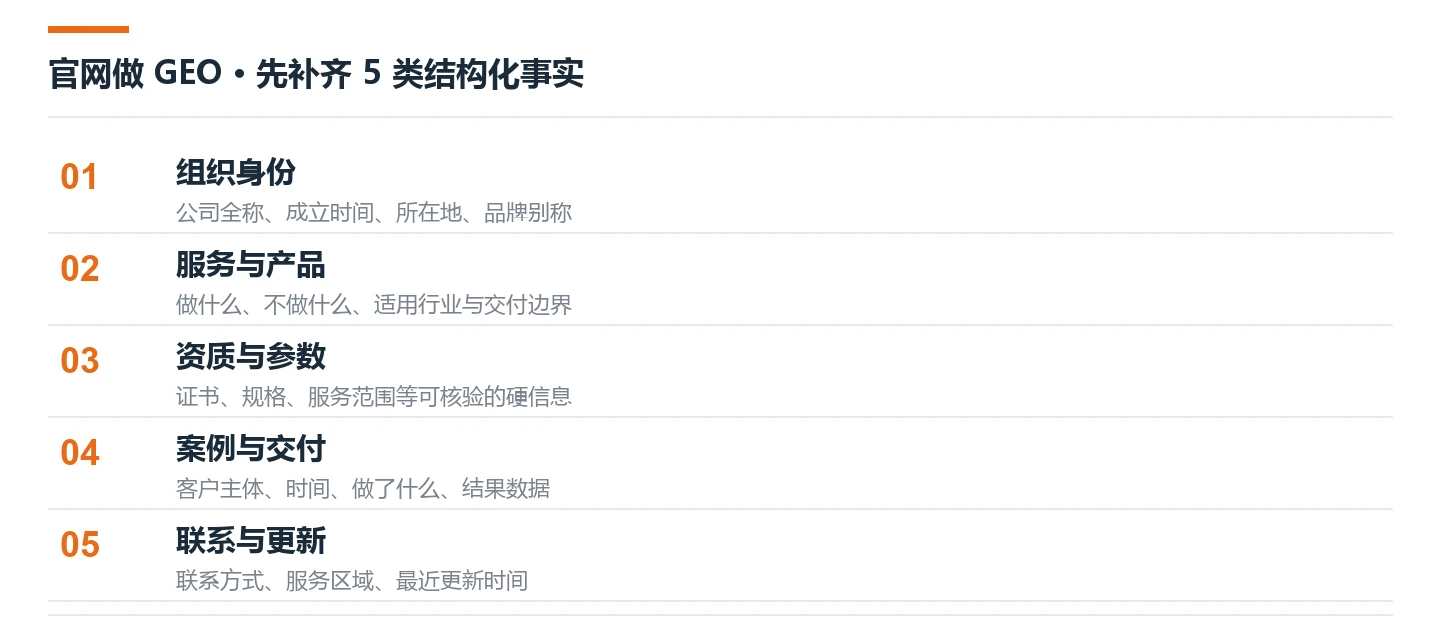
第一步,统一事实。把公司全称、成立时间、服务清单、案例与联系方式在官网上写清楚,并统一全网口径。这一步只改文案,不动结构,成本最低、收益最直接。
第二步,铺 Schema。在已有的关于我们、服务页、FAQ 与案例页上补结构化标注,字段值与页面可见文字保持一致,不要为了「多铺几个类型」而标注页面上并不存在的内容。
第三步,加 llms.txt。把最希望被读取的核心页面列成清单,写明站点定位与内容边界,随站点改版同步更新。
这三步都不要求重做官网。反过来,如果先写 llms.txt 却发现页面里没有可引用的事实,说明书指向的就是一堆形容词。
三、三个常见误区
把它当开关。llms.txt 目前并不是行业强制标准,各家模型是否读取、如何读取并不公开承诺;把它当作补充入口,而不是收录保证。堆砌标注类型。Schema 的价值在于与页面事实一致,类型越多不等于越容易被采信。写完不再维护。服务调整、电话变更、栏目改版后,标注与说明文件都要跟着改,过期信息会稀释可信度。
四、延伸阅读
术语层面可先看《GEO 是什么》与《AEO 是什么?答案引擎优化与 GEO 的关系》,把概念边界厘清;再按上面的顺序回到自己站点逐项核对。需要把这件事纳入常规运维,可参考GEO 智能引流的服务范围。
说到底,这两样东西都是「说明书」,不是内容本身。内容仍然是主角,说明书只是让机器更快找到、更准确理解它。